jak sprzedać siebie?

dosyć znana postać – guy kawasaki, napisał w swoim blogu co zrobić by dostać robotę w dolinie krzemowej.

opis jest mocno konkretny – i (w/g mnie) nie tyczy się tylko i wyłącznie doliny, ale dowolnego innego miejsca – w tym i firm w polsce. polecam przeczytanie, bo może zmodyfikuje to wasze podejście do pisania c.v., czy przygotowywania sie do rozmów o pracę.

google office. poniekąd.

od wczoraj writely przyjmuje już nowych użytkowników.

jakbyście nie kojarzyli – writely to edytor tekstu webowy, kupiony przez google'a jakiś czas temu.

w chwili obecnej google ma już:

  • program pocztowy
  • edytor tekstu
  • arkusz kalkulacyjny
  • kalendarz
  • poniekąd bazę danych

dużym brakującym składnikiem pozostaje soft do prezentacji. kiedy i który zostanie kupiony? a może to napiszą samemu?

tesla roadster – wieści z frontu i filmik

samochód którym się ostatnio zachwycam – tesla roadster miał swój oficjalny premierowy pokaz 19 lipca. tuż po pokazie 3 osób zapisało się na te samochody. teraz lista osób oczekujących ma już 100 osób – a jak na razie tylko kilka egzemplarzy zostało ukończonych.

jako dodatek – mały filmik (z reklamamy przed filmem niestety) gdzie widać jak to cudeńko jeździ.

nowy system replikacyjny do postgresa i nie tylko!

enterprisedb, firma której przedstawiać chyba nie muszę, od wczoraj oferuje swoje rozwiązanie replikacyjne: EnterpriseDB Replication Server.

co to i co potrafi?

na pierwszy rzut oka to co slony:

  • asynchronicznie
  • master + multi-slave

do tego niby jakieś narządka tylko replication console.

diabeł (a w tym przypadku raczej anioł) tkwi w szczegółach.

po pierwsze – do rzeczonego silnika replikacyjnego jest coś o nazwie: “Database Pooling Connection Framework". z tego co zrozumiałem z jednozdaniowego opisu, wynika, że zarządza to rozrzucaniem zapytań po bazach master/slave. i to w sposób w miarę inteligentny – wykrywając zapytania modyfikujące?!

po drugie – ten silnik replikacyjny pozwala replikować między postgresem i enterprisedb – co jest oczywiste, bo enterprisedb to też postgres. ale potrafi też replikować z/na oracle'a!

jest to o tyle dodatkowo ciekawe, że enterprisedb (firma) oferuje też pakiet do postgresa dla zachowania dużej kompatybilności zapytań. idea jest taka, że zapytania z oracle'a, działają na postgresie (a dokładniej na enterprisedb).

czyli całośc pozwala na zrobienie live migracji na postgresa a potem przepięcie aplikacji klienckich, albo ich część, na bazę która jest sporo tańsza!
całość pewnie będzie trochę kosztowała, ale może się okazać interesującą alternatywą dla slony'ego w zastosowaniach bardziej komercyjnych.

nowa zabawka – część trzecia, ostatnia

dostałem informację ile kosztowały te maszynki.

starsza, w/g ceny z 27 lipca 2005 – około $8300 (podaję ceny w dolarach, bo maszyny były kupowane w różnych krajach, od różnych dostawców).

nowa – (w/g ceny z 22 czerwca 2006) – około $55700.

czyli starsza jest 6.7 raza tańsza niż nowsza, a daje wydajność (w/g testów) na poziomie 6.1 raza wolniej niż nowsza.

czyli teoretycznie starsza jest lepsza.

ale z drugiej strony – są zadania których starsza w ogóle nie zrobi, gdyż ma tylko 4 giga ramu i mało dysków. za większe pieniądze dostaliśmy sporo szybszą maszynę, która potrafi robić też rzeczy które są fizycznie nieosiągalne dla tańszej (no chyba, żeby ją rozbudować, ale to też koszt).

reasumując – maszynka (nowa) jest w/g mnie całkowicie warta swojej ceny i mogę każdemu polecić taką konfigurację.

blogi polityków – zmiana postrzegania sieci?

jakiś czas temu antyradio (a może to była inna stacja) testowało czy politycy odpowiadają na emaile. generalnie – nie. w dodatku część pewnie nawet do nich nie zagląda, bo w kilku przypadkach dostali komunikat o przepełnieniu skrzynki.

czyli zasadniczo internet był mocno olewany.

ale ostatnio się to zmienia.

najpierw dowiedziałem się, że nasz były premier i obecny prezydent warszawy (p.o. prezydenta, czy jakoś tak) – kazimierz marcinkiewicz ma bloga. no cóż. on zawsze był “medialny".

potem się okazało, że bloga zaczął prowadzić mahmoud ahmadinejad – prezydent iranu. blog jest pisany w ichniejszym języku (perski/farsi), ale jest też tłumaczony na angielski.

potem się okazało, że blog prezydenta iranu pełni też inną rolę – gościom którzy wchodzą tam z ip które są wpisane jako należące do izraela, poza standardową zawartościa jest wysyłany trojan. ot. taki drobny “żarcik".

a dziś dowiedziałem się, że angela merkel, kanclerz niemiec ma swój vlog! na wypadek jakbyscie nie byli na bieżąco z nowym sieciowym słownictwem – vlog to video-blog, czyli blog gdzie zamiast wpisów są filmy.

jestem zszokowany. czy to ma oznaczać, że politycy zaczynają rozumieć znaczenie sieci? tzn. ja wiem, że każdy polityk ma gdzieś w hasłach “internet dla wszystkich", ale to taka kiełbasa wyborcza. a tu się okazuje, że (część z nich) idzie z postępem i rozszerza metody dostępu do ludzi. super. ciekawe kiedy to zadziała w drugą stronę i będzie można u nas, w polsce, załatwić coś administracyjnego emailem czy stroną webową. ale to pewnie nie za mojego życia.

nowy zakup googlea

google kupił firmę neven vision.

czym się firma zajmuje? na blogu googla jest mocno ogólnikowo, że rozpoznawaniem obrazu. strona firmy neven vision już nie działa. jest tylko informacja, że google ich przejął. i nic więcej.

ale cóż to dla mnie. chwila poszukania i oto:

Neven Vision's computer vision technology is the fastest in the industry and represents leading accomplishments in this field. Several U.S. patents have been granted to Neven Vision for its unique inventions. U.S. government and independent observers have recognized the underlying technology as most advanced with respect to accuracy, speed and efficiency.

The core building blocks of the company's vision-enabled products and services are our patented face and object recognition engines. Below is a simple representation of how each of these engines work.

  • Faces in an image are automatically detected by a robust face finder component that determines the position and size of the face in real world conditions (varying illumination, pose and expression).
  • A second processing stage determines the position of local features on the face, called “landmark findingâ€?.
  • Then a Gabor Wavelet transformation takes place to compute the “face-templateâ€? from the local features by extracting the template from an image that contains the essential, condensed facial information needed to determine a person's identity (a “face-templateâ€? is only about 1kByte in size; min <350bytes max 1.6KBytes). Two templates are then compared to yield a similarity. Templates belonging to the same person produce high similarity while templates from different persons produce low similarities.

Neven Vision's object recognition technology is based on a local feature approach:

  • Objects are recognized by identifying characteristic points of an object, deriving feature vectors from the texture in the vicinity of the characteristic points.
  • These feature vectors are then compared to a database of known objects to establish matching correspondences between the current object and the objects contained in the database.
  • If a sufficient number of local feature correspondences are found, a positive identification is accepted.

brzmi bardzo interesująco. o ile pamiętam oprogramowanie tego typu było używane także w systemach monitorowania lotnisk – do wyłapywania terrorystów.

raczej wątpię by google zaczął inwestować teraz w soft antyterrorystyczny, ale widzę interesującą możliwość – zapisujemy gdzieś jakieś zdjęcie np. wujka jurka. potem każde zdjęcie gdzie on się pojawia dostaje automatycznie taga “wujek jurek". to “gdzieś" jest oczywiste – picassa albums.

mam nadzieję, że technologia neven vision zostanie szybko zintegrowana z images.google.com dzięki czemu będę mógł szukać nie tylko po keywordach stron czy nazwach plików, ale po faktycznej zawartości obrazków.

nowe opterony

amd wypuścił własnie na rynek nową serię opteronów – “rev. f".

zmiany? całkiem spore: dodane sprzętowe “wsparcie" wirtualizacji, obsługa pamięci ddr2.

już w tej chwili wszyscy najwieksi zapowiedzieli wypuszczenie nowych serwerów z tymi chipami: hp, ibm, sun. za chwilę pewnie dołączy dell.

procesory te zawsze były moimi ulubionymi (do serwerów oczywiście) – i chyba nie tylko moimi. w/g badań rynku 25% światowego rynku serwerów “chodzi" na opteronach!

jedną z mniej technicznych, ale interesujących zmian, jest modyfikacja nazewnictwa. zamiast 3 cyfrowych,  nowe opterony będą miały 4 cyfrowe oznaczenia z opcjonalnymi dodatkami: “he" lub “se". he – chipy o niskim zużyciu prądu – nie do końca wiem po co – w końcu chyba nikt nie robi laptopów z opteronami? se – “super ekstra" – zoptymalizowane pod względem wydajności. wyżej taktowane, ale zuzywające więcej prądu.

dokładny opis nazewnictwa jest oczywiście na stronach amd, ale tak skrótowo:

numer składa się z 4 cyfr: abcd
a – ile maksymalnie procesorów tego typu może razem działać. możliwe wartości: 1 – (chyba nikt na świecie tego nie używa), 2 (najpopularniejsze) i 8 (rzadziej spotykane, bo sporo droższe)

b – rodzaj gniazda. na razie wszystkie mają tam wartość “2".

cd – dwucyfrowa liczba. im więcej tym lepiej. odpowiada częstotliwości. wartość “10" oznacza 1.8 ghz. “skacze" co 2, i każdy kolejny skok to o 200 mhz więcej.

czyli np:

opteron 8216, to procesor działający w zestawach do 8 procesorów na raz, o częstotliwości 2.4 ghz.

modele – h.e – mają takie same parametry jak modele standardowe.

modele – s.e. są taktowane wyżej niż by na to wskazywał numer. np. 2220 se zamiast być taktowany 2.8, ma równe 3 ghz.

mniam. ciekawe kiedy dostanę takie cudo do potestowania 🙂
nowa zabawka – c.d.

tak jak obiecałem – zrobiłem mocniejsze testy.

najpierw tylko takie info – jak pamiętacie poprzednio robiłem pgbencha -s 750. i na ustawieniach praktycznie “defaultowych" robił maksymalnie 830 tps. po dokonfigurowaniu robił (przy 100 połączeniach jednocześnie, czyli wtedy gdy poprzedni config robił 780-790) w zależności od nie wiem czego od 960 do 1070 tps'ów. całkiem ładnie.

potem zrobiłem bazę ze skalą pgbencha 7500. wielkość bazy – 120 giga, czas robienia pgbench -i – 150 minut.

ponieważ każdy test (każde concurrency) robię na czystej bazie, stwierdziłem, że robienie za każdym razem inicjalizacji po 150 minut odpada.

skopiowałem więc cały katalog $PGDATA na bok, i robiłem testy kopiując co test czysty katalog na miejsce “zużytego".

skrypt testujący:

#!/bin/bash -x<br />
export TOTAL_TRANS=1000000<br />
for C in 1 5 10 15 20 25 30 35 40 45 50 55 60 65 70 75 80 85 90 95 100 105 110 115 120 125 130 135 140 145 150 155 160 165 170 175 180 185 190 195 200<br />
do<br />
rm logs/* -f<br />
pg_ctl -w -l logs/x.log start<br />
TRANS=$[ $TOTAL_TRANS / $C ]<br />
pgbench -s 750 -c $C -t $TRANS -U pgdba -d bench 2> /dev/null > /home/pgdba/bench-$C.std<br />
pg_ctl -m immediate stop<br />
killall -9 postgres<br />
killall -9 postmaster<br />
killall -9 postgres<br />
killall -9 postmaster<br />
rm -rf /mnt/postgres/pgdba/data<br />
cp -a /mnt/postgres/pgdba/data.back /mnt/postgres/pgdba/data<br />
done

proste i miłe 🙂

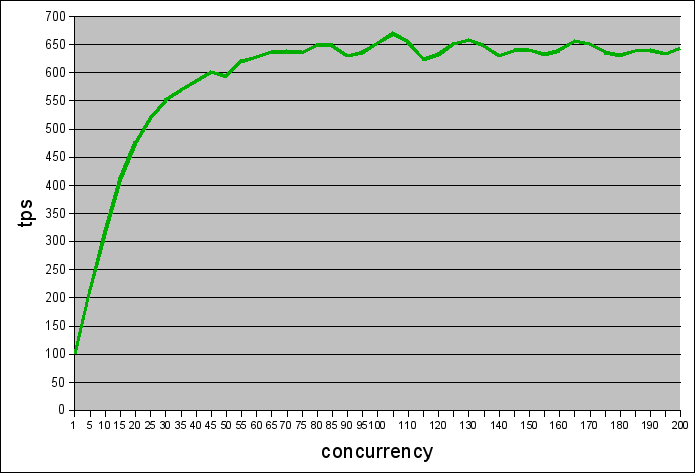
wyniki wyglądają tak:

7500-db7-opti.png

jest lepiej niż poprzednio – nie ma takiego spadku wydajności.

co interesujące – są skoki o amplitudzie około 50tps, ale wydaje mi się, że mogą one być spowodowane aktywnością poza-bazodanową (cron).
całość osięgnęła stabilną średnią około 640 tps. dla przypomnienia – przy wielkości bazy 4 razy większej niż ram. całkiem przyjemny wynik.